Мы хотим, чтобы нейросеть-художник научилась рисовать нашего кота — в любых позах, стилях, на любых фонах. Но даем ей всего одну фотографию. И здесь начинается одна из самых деликатных проблем современного генеративного ИИ: вместо того чтобы запомнить кота, нейросеть намертво выучивает конкретный ракурс, конкретный диван на фоне и конкретное освещение из той единственной фотографии. Исследователи из ВШЭ, МФТИ и Института системного программирования им. В. П. Иванникова РАН нашли элегантный математический способ это исправить и опубликовали его в IEEE Access.
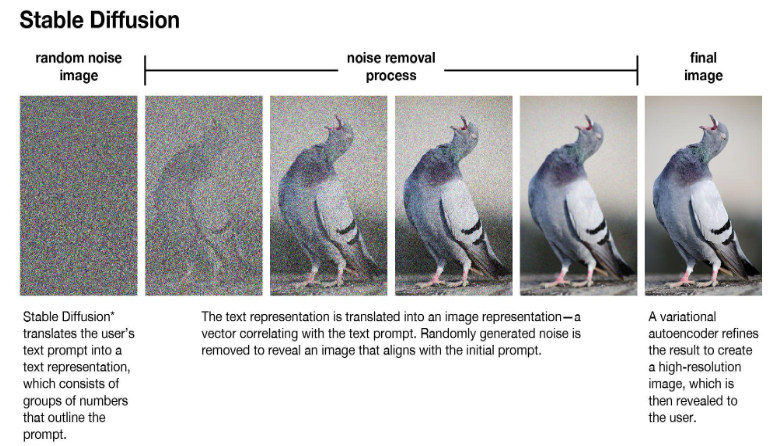
Диффузионные модели — это класс генеративных нейронных сетей, которые буквально «разучиваются» добавлять шум к изображению, а потом применяют этот процесс в обратном направлении, превращая случайный шум в картинку по текстовому описанию. Именно на диффузионных моделях работают Stable Diffusion, DALL·E и Midjourney.
Технология DreamBooth позволяет «дообучить» такую модель под конкретный объект — человека, питомца, товар, используя несколько целевых фотографий. Проблема заключается в том, что при малом количестве обучающих примеров модель «переобучается»: она запоминает не суть объекта, а все случайные детали конкретных фотографий. Попросите ее нарисовать кота в космосе, и она нарисует кота на том же диване, но с нарисованным космосом вокруг. Это называется меморизацией контекста, и бороться с ней при минимуме данных крайне сложно.
Процесс диффузии состоит из T шагов: на каждом шаге к изображению добавляется немного шума, пока оно не превратится в случайный «белый шум». При обучении нейросеть учится предсказывать, какой шум был добавлен на каждом шаге.
Ключевое наблюдение авторов: шаги с малым шумом (в начале процесса, близко к чистому изображению) несут в себе тонкие детали внешности — текстуры шерсти, форму носа, характерный цвет глаз. Шаги с большим шумом (в конце) кодируют только грубую глобальную структуру — общую форму, схему расположения элементов. Стандартное обучение выбирает шаги случайно, равномерно, то есть одинаково много внимания уделяет как «детальным» малошумовым шагам, так и «структурным» сильношумовым. Исследователи предложили это изменить.
Метод P-LoRA (Probability LoRA) изменяет распределение вероятностей, с которым выбираются шаги диффузии при обучении. Вместо равномерного выбора модель чаще сталкивается с малошумовыми шагами, теми, которые несут информацию об идентичности объекта. При этом математический трюк позволяет сохранить неизменность самой оптимизируемой функции потерь: к каждому шагу применяется корректирующий вес, равный отношению равномерного распределения к использованному смещенному.
Благодаря этому градиенты в среднем остаются такими же, как при равномерном обучении,— никакого сдвига в распределении данных, никакой нестабильности обучения. По сути, метод перераспределяет «вычислительный бюджет» в пользу тех шагов, где объект всего виднее, не нарушая математической корректности процедуры.
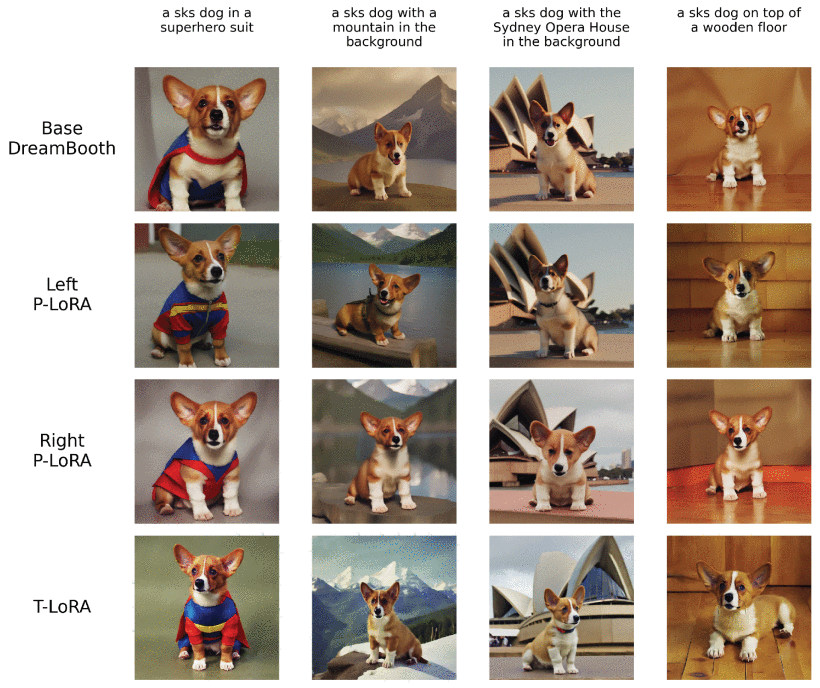
Авторы протестировали три конфигурации: обычный DreamBooth с равномерным выбором шагов, P-LoRA с уклоном в сторону малошумовых шагов и P-LoRA с уклоном в сторону сильношумовых (как контрольный эксперимент). Оказалось, умеренный уклон к малошумовым шагам улучшает редактируемость, то есть способность нейросети откликаться на новые текстовые запросы, помещая объект в неожиданные контексты, при этом не теряя качества воспроизведения объекта. Уклон к сильношумовым шагам снижает «запоминание» фона, но за счет худшего воспроизведения самого объекта.
Для оценки результата авторы также ввели новую метрику — «чистый» показатель реконструкции, который перед измерением схожести с эталонной фотографией предварительно вырезает фон с помощью модели сегментации. Это позволяет измерять именно то, насколько хорошо модель выучила объект, а не случайные детали окружения.
Метод практически не требует дополнительных вычислительных ресурсов по сравнению со стандартным DreamBooth + LoRA: он не добавляет ни дополнительных проходов через сеть, ни новых параметров модели, ни дополнительной памяти. Изменяется только распределение, из которого выбираются шаги, и добавляется скалярный вес к потере. Это означает, что метод можно встроить в любой существующий диффузионный пайплайн буквально за несколько строк кода. Такая «легкость» особенно ценна для практиков, которые работают с ограниченными вычислительными ресурсами и не могут себе позволить полное переобучение больших моделей.
Максим Фофанов, магистрант кафедры алгоритмов и технологий программирования МФТИ, пояснил: «Главная идея — очень простая: не все шаги диффузии одинаково полезны для обучения персонализированной модели. Малошумовые шаги несут в себе ту тонкую информацию об идентичности, которую мы хотим, чтобы модель выучила. Перераспределив туда больше обучающих примеров и исправив математическое смещение контрвесами, мы смещаем внимание модели именно туда, где оно нужно».
Диффузионные модели сделали AI-генерацию изображений доступной для всех. P-LoRA делает следующий шаг — от «умения рисовать что угодно» к «умению рисовать именно это». В эпоху, когда каждый хочет иметь персональную нейросеть-художника, которая знает тебя в лицо, этот шаг имеет не только технологическое, но и глубоко человеческое измерение.
Научная статья: Mamedov I. G., Fofanov M. A., Lukianchenko P. P., Lisov R. V., Teplov A. R., Barkina A. S. Focusing the Diffusion: Importance Sampling for One-Shot Subject-Driven Image Generation // IEEE Access. Vol. 14, 2026. DOI: https://doi.org/10.1109/ACCESS.2026.3662766
